在超算集群上提交一个 GPU 作业,标准做法是写一长串 jsub 参数:节点组、节点名、核数、卡数、队列、作业名、输出文件…… 参数记错一个,作业就提交失败,报的还是看不懂的英文错误。
这个工具就是为了解决这件事:把参数变成界面,把脚本交给程序生成。
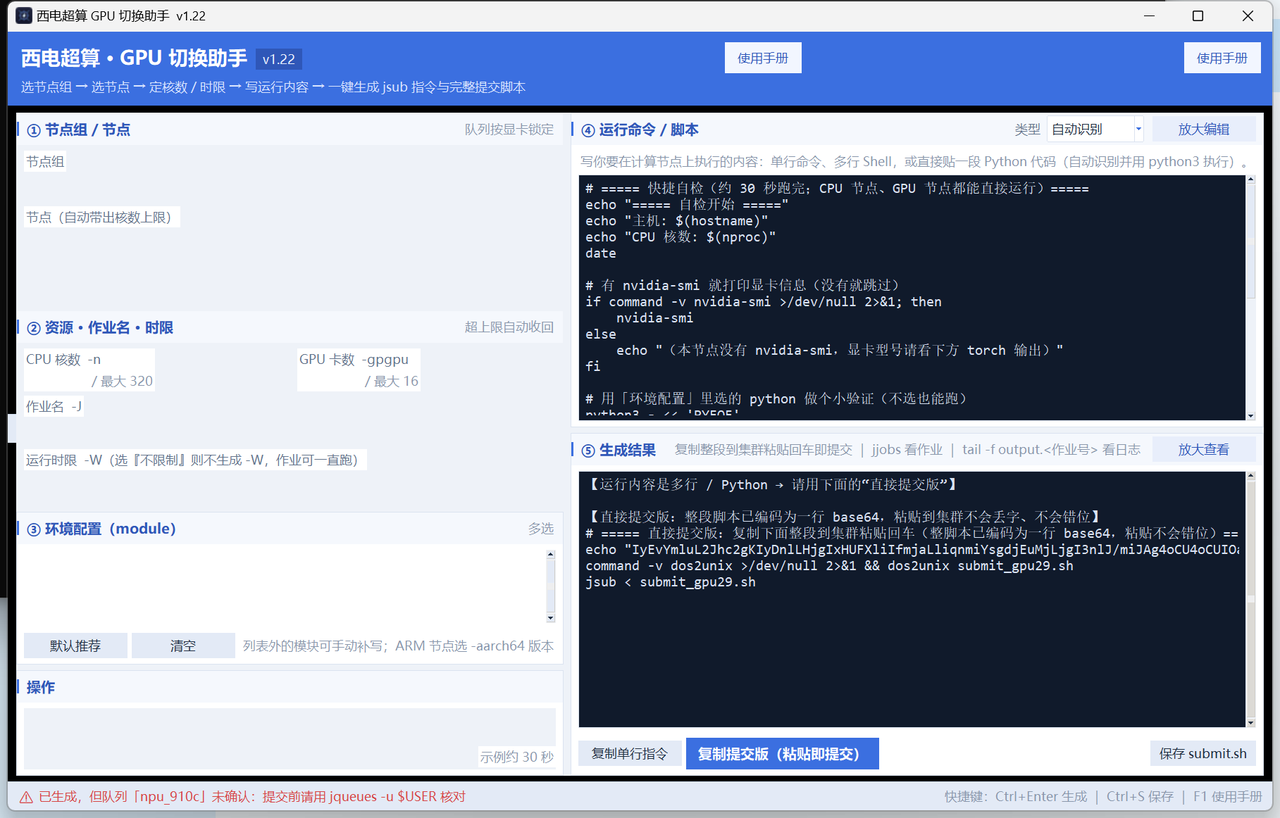
它做了什么
- 选节点 = 自动锁定队列:选中某个节点后,队列名自动带上。这一条尤其关键 —— 平台里
fat01-06的队列其实是cpu_x86fat,cu06-13挂在cpu_x86thin下,手写极容易写错 - 三种提交产物:单行
jsub指令 /#JSUB完整脚本 / base64 直接提交版(整段脚本压成一行,粘到集群不会乱码、不会错位) - 代码自动识别:在界面里直接写 Python,自动用 heredoc 打包,中文输出也正常
- 环境模块清单:CUDA 11.8~13.2、PyTorch 2.5.1、MPI、GROMACS / LAMMPS / NAMD / VASP 等二十余个,点选即用
- 防手滑:核数超过节点上限自动收回,作业名和时限有校验,未确认的队列会黄条提醒
技术上值得说的几点
1. 队列名不是猜的,是实测出来的。
用测试账号在集群上跑 jqueues / jhostgroup 逐个核对,发现两个会导致提交失败的映射错误并修掉,同时把「队列名核对」写进了自测脚本 —— 以后谁改错,--selftest 会直接失败。
2. base64 方案解决的是”复制粘贴”这个真实痛点。 从 Windows 复制多行脚本到集群终端,经常出现缩进丢失、中文乱码、换行被吃。把整段脚本 base64 编码成一行,在集群侧解码执行,本地与远端的 md5 完全一致 —— 实测过 1310 字节的脚本,md5 分毫不差。
3. 自测是打包流程的一部分。
build.bat 的顺序是:跑自测 → 通过才打包 → 复制成品。这样”能编译”不等于”能用”,逻辑坏掉会直接卡在第一步。
实测记录
| 验证项 | 结果 |
|---|---|
| GPU 队列提交(gpu15 / gpu_6000ada) | 作业成功,显卡为 RTX 6000 Ada |
| base64 提交版 md5 比对 | 本地与集群完全一致 |
| 界面写 Python → 提交 | torch 2.5.1 / CUDA 可用,中文输出正常 |
| 故意写错代码 | error.<作业号> 有完整 traceback,不会静默失败 |
怎么用
① 左栏:选节点组 → 选节点 → 核数 / 时限 / 环境 module
② 右栏:写运行内容(命令 / Shell / Python 均可)
③ 点「复制提交版」→ 粘到集群登录节点回车
源码和 exe 都在这里:sakurajh/gpu-switch-helper
这种”把重复劳动变成一键脚本”的活儿,是我最喜欢做的一类 —— 收益不一定立刻看得见,但每天都在省时间。
评论与讨论
使用 GitHub 账号登录即可留言(首次使用需在 giscus 中授权)